Microsoft prévoit un million de puces Maia 300 pour faire tourner sa propre IA
Microsoft dit qu'il pourrait déployer plus d'un million de puces Maia 300 en 2027 pour faire tourner ses propres services d'IA. La conception en chiplets revendique 40 pour cent de calcul utile en plus par mégawatt que les principaux systèmes à GPU.
Points clés
- SAN FRANCISCO : Microsoft a annoncé le Maia 300 lundi 12 octobre, la troisième génération de sa propre puce d'IA, et a dit qu'il prévoyait de déployer potentiellement plus d'un million…
- L'échelle est l'histoire.
- La puce vise l'inférence, le travail qui consiste à faire tourner un modèle entraîné pour répondre à une question, écrire du code ou gérer une tâche professionnelle.
SAN FRANCISCO : Microsoft a annoncé le Maia 300 lundi 12 octobre, la troisième génération de sa propre puce d'IA, et a dit qu'il prévoyait de déployer potentiellement plus d'un million d'exemplaires l'an prochain. Les puces feront tourner les services internes d'IA de Microsoft, le travail derrière des produits comme Microsoft 365 Copilot et GitHub Copilot, et les modèles d'OpenAI proposés sur Azure. Microsoft a dévoilé la puce à l'OCP Global Summit à San Jose.
L'échelle est l'histoire. Un déploiement de plus d'un million de puces fait passer Maia d'une expérience à une infrastructure centrale. Microsoft s'attend à ce que les dépenses d'investissement dépassent 175 milliards de dollars cette année calendaire, et une large part de cet argent est allée à Nvidia. Le Maia 300 est conçu pour garder davantage de ces dépenses en interne.
Conçu pour l'inférence, construit par pièces
La puce vise l'inférence, le travail qui consiste à faire tourner un modèle entraîné pour répondre à une question, écrire du code ou gérer une tâche professionnelle. Nvidia reste en tête sur l'entraînement, le travail plus lourd qui consiste à construire des modèles à partir de zéro. Microsoft a conçu le Maia 300 pour le côté exécution, et dit qu'il deviendra le principal système d'inférence pour ses produits et services à partir de 2027.
La conception diffère de l'approche de Nvidia. Nvidia construit un grand processeur entouré de mémoire à large bande passante. Microsoft a construit le Maia 300 à partir de chiplets, de plus petites pièces spécialisées liées entre elles. Les chiplets de calcul clés utilisent le procédé 2 nanomètres de TSMC. Des chiplets 3 nanomètres moins chers s'occupent de déplacer les données dans le système.
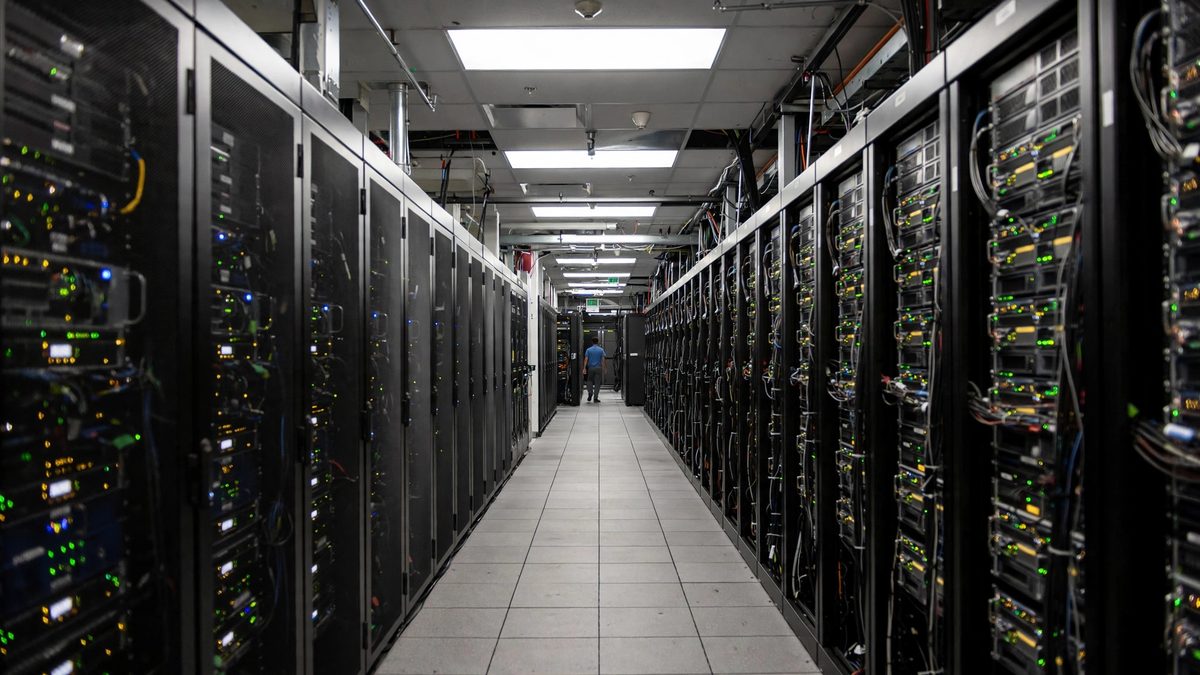
Au niveau du rack, le compromis se voit dans les chiffres. Un rack Maia 300 contient 96 puces et consomme environ 167 kilowatts. Le rack GB300 de Nvidia contient 72 processeurs graphiques et consomme environ 142 kilowatts. Plus de puces, plus de puissance. Microsoft dit que le rendement est d'environ 40 pour cent de calcul utile en plus par mégawatt que les principaux systèmes à base de GPU. L'entreprise n'a pas nommé les systèmes auxquels elle s'est comparée, donc ce chiffre doit être traité comme une revendication à tester, pas comme un résultat.
Une lignée de puces
Le Maia 100 est arrivé en 2023. Le Maia 200 a été annoncé en janvier 2026 et fait désormais tourner du travail en production, dont les produits Copilot et les modèles d'OpenAI sur Azure. Le vice-président exécutif Scott Guthrie a dit que le Maia 300 utilise une conception axée d'abord sur l'inférence, réglée pour les contextes longs et le travail gourmand en mémoire, et qu'un rack de 96 puces offre sept fois le débit de jetons au niveau du rack du Maia 200. Les puces sont réservées aux propres services de Microsoft plutôt que louées comme capacité externe.
Pourquoi c'est important
Chaque grande entreprise du cloud conçoit désormais son propre silicium, et chaque conception entame l'emprise de Nvidia sur le calcul d'IA. Les puces sur mesure changent aussi le calcul des coûts derrière les produits d'IA. Si Microsoft peut faire tourner les fonctions Copilot sur son propre matériel à un coût par réponse plus bas, la pression sur les prix de l'IA dans tout le secteur augmente. La même semaine, les marchés des puces ont fortement chuté sur des nouvelles d'une avancée chinoise en mémoire. La course au matériel avance sur plusieurs fronts à la fois.
Et maintenant
Le déploiement arrive en 2027, dans ce que Microsoft appelle des installations de plusieurs gigawatts. Il faudra surveiller les premières lectures indépendantes sur la revendication d'efficacité de 40 pour cent quand des utilisateurs externes pourront tester les systèmes, et la réponse de Nvidia sur les prix de l'inférence.